-
On cowardness in Clojure code
Imagine you have a function accepting a value and doing something with it:
(defn double-number [x]
  (when x
    (* x 2)))

;; or

(defn get-user [id]
  (when id
    (jdbc/execute! *db* ["select..." id])))
A common pattern which comes all the time is to wrap the entire body with a
(when id ...)form. You don’t want to process nil values so it’s safer to protect yourself against NPEs. Without(when ...), a nil value can ruin the entire pipeline, cause a null pointer error, trigger DB queries in vain and so on. These all sound reasonable, yet I’ve got my own term to describe such a kind of code: “coward style”.A person who is wrapping the whole function with
(when)isn’t getting one thing. If a function had been given nil, it should have never been called instead. Clojure provides a number of macros to call a function conditionally depending on arguments, for example:(some-> (get-user-id) (get-user))Should
(get-user-id)return nil, the(get-user nil)form never gets called. The same applies to(cond->)and other macros that build an execution form conditionally.In other words: a function must not check its input parameters for nils. But those people who call this function must.
Now let me explain the “coward style” I mentioned before. It’s when people write like this:
(defn double-number [x]
  (when x
    (* x 2)))
I don’t know what this code tells you, but to me, it’s clearly this: “Guys, I don’t want any problems. I don’t want any exceptions to be raised. If you supply me with a number, I’ll double it but won’t do anything if you pass nil. I cannot process it but won’t argue on you. Let’s keep it all quiet. Deal?”
This is a speech of a typical coward: I don’t want problems. I don’t want stack traces. I don’t want alerts and investigations. Let’s be quiet. The job is half-way done in fact as the function works partially. It won’t tell you when something is not quite right.
I’ve seen plenty of computation chains like this:
(-> some-param
    (parse-param)
    (pre-process-param)
    (get-use-id)
    (get-user-by-id)
    (send-user-somewhere))
Now imagine that every function starts with
(when ...), and the final function crashes with NPE. It will be quite challenging to find who is guilty. These functions are real cowards: nobody wants to take blame. “I got nil → I returned nil. Not my business. I washed my hands”.Thus, stop writing functions starting with
(when ...). If a function silently swallows a nil value doing nothing, sooner or later you’ll pay for that. Or your teammates will.There is still a way though to protect yourself against nils which I like a lot. Use built-in pre- and post conditions:
(defn double-number [x]
  {:pre [(number? x)]}
  (* x 2))
Now if you pass nil, you’ll get a clear error
(double-number nil)

;; Execution error (AssertionError) at … (REPL:211).
;; Assert failed: (number? x)
Preconditions help a lot with guessing types. Above, they clearly say
xmust be a number and nothing else. In addition to:preand:postforms, the standard(assert ...)form might help in the middle of a function to interrupt execution when you know it makes no sense to go on with a weird value.Keen mind that
:pre,:post, andassertforms rely on the global*assert*variable. It’s a good practice to rely on assertions a lot but wipe them off on production as they slow down the code. When baking an uberjar, setclojure.core/*assert*to false. If it’s ClojureScript with a shadow compiler, pass{:elide-asserts true}into the:compiler-optionsmap for a production release.I agree that pre/post and assertions take lines of code, and sometimes they make code a bit noisy. But they will save you hours of debugging. Don’t be a coward whose main goal is to avoid exceptions. Don’t hide weird things. Be simple and explicit, and let your code express these two qualities.
-
Глава 10. Релевантный поиск
Главы
- Введение в документы
- Базовые возможности JSON
- JSON в таблицах
- Индексирование JSON
- Ограничения в документах
- Язык путей JSONPath
- Отчеты, функции, расписание
- Функции на языке Python
- Версии и патчи
- Релевантный поиск
Содержание
- Главы
- Поиск в конкатенации полей
- Слоеный поиск
- Замечания к UNION
- Последующая обработка
- Замена UNION на FULL JOIN
- Коротко о MapReduce
- Поиск в исторической таблице
- О быстродействии
- Дальнейшие улучшения
- Страничная навигация
- Полнотекстовый поиск
- Объект запроса
- Определение и хранение языка
- Полнотекстовый слой в UNION
- Оптимизации и доработки
- Заключение
В последней главе речь пойдет о релевантном поиске документов. При таком поиске документу назначено число, которое означает, насколько точно он подходит запросу. Мы узнаем, как выбирать документы по разным критериям, ранжировать и объединять их двумя способами. В числе прочего мы рассмотрим полнотекстовый поиск силами
tsvectorиtsquery.В главе про индексы мы упомянули поиск документов. Поиск необходим любой системе, неважно стартап ли это или крупный банк. В основе поиска лежат правильные индексы, но их одних недостаточно: понадобятся и другие техники.
-
Глава 9. Версии и патчи
Главы
- Введение в документы
- Базовые возможности JSON
- JSON в таблицах
- Индексирование JSON
- Ограничения в документах
- Язык путей JSONPath
- Отчеты, функции, расписание
- Функции на языке Python
- Версии и патчи
- Релевантный поиск
Содержание
- Главы
- Историческая таблица
- Демонстрация
- Создание версий
- Версии на триггерах
- Доводы против триггеров
- Версии в приложении
- Версии в Postgres
- Ограничение по времени
- Восстановление версии
- Архивация версий
- Стандарт JSON Patch
- Патчи в приложении
- Патчи в базе данных
- Версии с патчами
- Прием патчей от клиента
- Коротко об event-sourcing
- Сбор агрегатов из событий
- Махинации с патчами
- Бесконфликтное редактирование
- Решение конфликтов
- Технические детали
В этой главе мы поговорим о том, как хранить разные версии одного документа. Обсудим, как организовать историческую таблицу, перемещать в нее документы и восстанавливать их. Также мы затронем тему разности JSON и познакомимся со стандартом JSON Patch (не путать с JSON Path).
Как мы упоминали, документ – это большая структура данных. Некоторые документы содержат сотни полей, и они часто меняются. При этом изменения фиксируют: создают резервные копии документов. Эти копии открывают полезные возможности, например:
- откатить ошибочную операцию, что важно в финансах и банковском секторе.
- Пересчитать какие-то показатели, если в прошлом это сделали неверно.
- Вести аналитику: смотреть как менялись сущности во времени, строить графики, отслеживать рост и падение показателей.
Некоторые разработчики уверены, что ответ на все перечисленное – бекапы. Чтобы получить документ во вчерашнем состоянии, нужно восстановить бекап на тестовую базу и прочитать его оттуда. Этот подход справедлив лишь отчасти, потому что восстановление бекапа – дорогая операция. Выполнять ее ради одного документа неэффективно. Иногда один и тот же документ нужен в нескольких срезах, и приложение не может ждать, пока восстановятся все бекапы.
-
Русская речь в фильмах
Иногда русская озвучка бывает, мягко говоря, спорной. Актеры кричат в тех местах, где персонаж шепчет; интонация странная, пропадают акценты, идиомы, игра слов. Так что если вам позволяют условия (знаете язык, партнер(ша) не возражает), потребляйте фильмы и игры в оригинале (или хотя бы ключевые сцены). У этого правила, однако, есть исключение: иногда в оригинале звучит русская речь. В таком исполнении, что хочется не слышать ее ни за какие деньги.
Имеем американского персонажа. Всем он хорош: и силен, и умен, и женщину спас. Одна беда – русского происхождения. И вот на середине фильма всплывает русская мафия, дядюшка или бывшая, с которыми герой изъясняется по-русски. То есть как по-русски: в Гугл-транслейт набивается текст на английском, тот выдает русский транслит. Актер учит его наизусть как абракадабру: “Татиана, как дафно ти юже десь?” Татьяна: “Пивет Джон, две ньидели ка пиехаля”.
Разумеется, у меня нет претензий к американскому зрителю. Им без разницы – русский, бурятский, венгерский – все это наречия каких-то варваров. Но куда смотрят создатели фильма? Разные факт-чекеры и консультанты, которые отвечают за реалистичность сцен. Неужели нельзя найти русскоговорящего актера с похожим голосом и озвучить пару фраз? В чем сложность?
Когда русский бандит обращается к американцам, проблемы не возникает. Тут даже переигрывают: “лэт мы спык ынглиш фр-р-ром май хар-р-рт”. Плохой персонаж всегда будет с рокочущим “р”. Как обезьянничать, так все мастера. А как насчет нормальной речи?
Много лет назад со мной был случай. Я играл в одну игру, и там на хороших парней (американцев) напали плохие (конечно, русские). Атаку отбили, и одного молодого бандита взяли в плен. А он оплакивает убитую шальной пулей сестру: Наташа, очнись, солнышко, пойдем… и все это – на чистом русском. Ощущение, словно за спиной кто-то говорит. Я аж подскочил на стуле.
Из Википедии и всяких ссылок я узнал, что этот фрагмент – инициатива русскоязычного сотрудника студии. Изначально дорожку записали как есть – транслитом. Вообразите, как звучали слова скорби из уст человека, который не знает языка? Картавые “встаувай, Натащья, ти живуа? Нье умиай!” Все это – в момент смерти? Это даже не кринж, а пиздец, и так делать нельзя.
Разработчик прекрасно это понимал и сделал вот что. Когда все ушли, он записал дорожку на нормальном русском и подменил в ассетах. Никто не заметил, и русская речь ушла в релиз. Позже игру хвалили в том числе и за это: впервые за вечность в игре адекватная речь, а не транслит.
Выходит, что инди-студия смогла, а Голливуд не может? Слабо верится.
Интересно, что в локализации фильмов мы не сталкиваемся с подобным кринжем: герой говорит с родными на нормальном языке, в то время как в оригинале звучит тарабарщина. Оригинал, увы, нет-нет да подкинет подобный сюрприз. Длятся подобные сцены недолго, но даже их хватает, чтобы свалится на пол от отчаяния и стыда.
-
Kill the cookie banner
Как-то давно, аж в 2023 году, я жаловался на куко-баннеры. Проблема вот в чем: сегодня почти любой сайт выстреливает плашкой, что использует куки. Десятилетиями мы с этим жили, но пришли европейские бюрократы и сказали: непорядок. Надо не только уведомлять, но и предлагать пользователю выбор. А то как же он, бедняга, без выбора? Изволь: все куки, только обязательные, необязательные и обязательные, свой выбор. Дополнительно прилагается простыня о том, как эти куки используются.
За европейскими бюрократами подтянулись другие по всему миру. Одновременно нам не повезло с дизайнерами: никто не стал договариваться, каждый пошел кто в лес, кто по дрова. Один сайт показывает выпадашку, другой две, третий – полоску, четвертый прячет контент и так далее.
И вот мечта еврочиновника сбылась: сайты уведомляют. Стало ли пользователю удобней и безопасней? Нелепый вопрос. Пользователю ничего не остается как ставить плагин “I don’t care about cookies”. Схожую функциональность добавили в блокировщики рекламы.
Последнее особенно забавно: между рекламой и куко-баннером нет разницы. Не все ли равно, что там в выпадашке? То и другое загораживает контент, поэтому выход — резать.
На мой взгляд, совершенно очевиден следующий факт. Если каждый сайт спрашивает о какой-то ерунде, эту ерунду выносят в настройки браузера. Должен быть особый раздел, где я жму галочку “пофиг на куки”. Это свойство доступно в JavaScript; сайт читает его и определяет, показывать окно или нет. Другой способ без JavaScript – отправить заголовок вида
X-Cookie-Policy-Preferences: pofigБэкенд проверяет значение на множество
all,none,essential-onlyи другие и определяет, показывать окно или нет.Можно написать спецификацию, которая учитывает важность кук, их характер (только айтишник, личные данные, настройки сайта) факт их передачи сторонним лицам и так далее. Все это технические детали, но важно одно: когда есть соглашение, под него можно сделать интерфейс.
Повторюсь, текущая ситуация, когда каждый сайт кукарекает о куках, никуда не годится. Чиновник доволен, а нам-то с вами этим пользоваться. Вспомните, что было, когда в браузеры добавили уведомления. Каждый сайт при открытии долбил: включи нотификации, включи нотификации, че ты как лох, включи-включи-включи. А еще дай доступ к геолокации и трекингу, чтобы два раза не вставать. Позже нотификации и прочий мусор вынесли в настройки: можно задать глобальное умолчание и исключения.
(В скобках: удивляюсь, почему нет глобального запрета на перевод страницы. Открыл сайт на английском – перевести на русский? Открыл на русском – перевести на английский? Чинится системной опцией в Firefox, а настройки “никогда ничего не переводить” до сих пор нет).
Так вот, к чему это все. Появилась инициатива под названием Kill the cookie banner! От каждой страны набираются волонтеры, которые будут сражаться за то, чтобы куко-баннер настраивался в браузере. Проект полезен уже тем, что показывает: есть люди, которым не все равно. Не хомяки вроде меня с плагином-банерорезкой, а те, кто хотят что-то изменить. Искренне желаю им успехов, пусть даже локальных, например на территории отдельных стран.
Напоследок напомню, что в интернете все еще есть сайты, которые прекрасно работают без кук. Например, мой. Посещайте его!
-
Блокнот
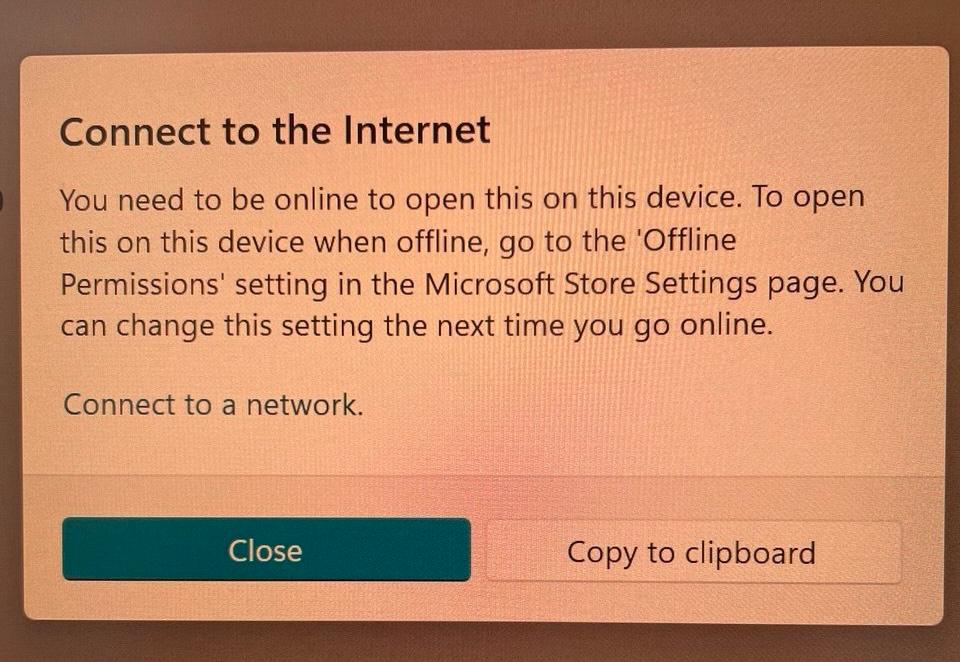
Оказывается, на 11 винде нельзя открыть блокнот (notepad.exe), если нет подключения к интернету. Причем как и все у микрософта, даже это ограничение сделано через задницу. По нажатию на иконку 20 секунд ничего не происходит, после чего вылезает плашка:
“Я не могу запустить это на этом устройстве. Чтобы запустить это, идите туда-то…”.
Зыс он зыс, ран зыс. Господи, какие же беспросветные уроды!
Честно говоря, не знаю, как можно пользоваться операционкой, где даже блокнот не запустишь без приключений. Яблочный софт в последнее время тоже не сахар, но хотя бы блокнот все еще открывается.
Кстати, недавно на работе была драма: люди обновили Edge и потеряли закладки, куки, историю. Взамен получили чистый браузер с приветствием: добро пожаловать в Edge!
Недаром Микрософт в последнее время называют Микрослопом. Все сходится.
-
Ссылки в терминале
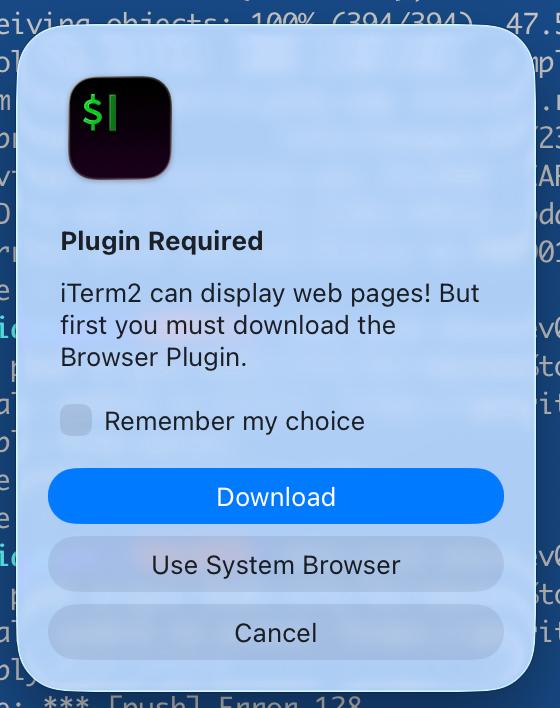
Искренне интересно: кто эти люди, которые открывают ссылки из терминала не в родном браузере, а в неком плагине? Представьте себе: у человека установлен Хром, возможно, Фаерфокс, системные браузеры: Edge или Сафари. И человек такой: нет, это не подойдет, открою-ка я ссылку в ПЛАГИНЕ. И кто-то сидел, писал этот плагин, настраивал интеграцию, добавлял модальное окошко, чтобы при первом клике по ссылке спросить: тебе родной браузер или плагин?
Апофеоз подобного дурдома поражает. Этот ваш браузер из плагина, где он хранит куки? Как долго? Что с защитой от трекинга и блокировкой рекламы? Как он настраивается? Очевидно же, что никак. Зачем писать барахло и засорять когда-то хорошую программу? Неужели все проблемы уже решили? Но самое главное — тезис из начала заметки: что было в голове у тех, кто написал этот плагин? А также у тех, кто добавил эту функциональность в релиз.
-
Статьи в Телеграме
Долгое время в Телеграме нельзя было постить текст с картинками. То есть было можно, но со скрипом. К обычному тексту нельзя добавить картинку, а если это сделать, то сообщение становится типом “медиа”, и его текстовая часть сильно меньше. Премиум закрывает этот недостаток, но появляется другая беда: текст выравнивается по ширине картинки. Если картинка маленькая, текст превращается в мышиный хвост.
В результате народ постил текст и картинки отдельно, чтобы не страдало ни то, ни другое. Но получается два сообщения, и если хочешь поделиться ими, приходится пересылать пару. Словом, бред.
Со временем Телеграм стал полноценной медиаплощадкой; есть даже проекты, у которых единственный канал – месаджер. При публикации картинок каждый извращался как умел: выносил их в галереи, объединял в коллажи и так далее.
И вот в Телеграм завезли полноценный визивиг-редактор. Это когда картинки и текст чередуются, и нет смысла делить публикацию на текстовый блок и медиа. Также сделали заголовки, списки и редактор таблиц – этакий Ворд.
Что ж, на словах все прекрасно, а вот на деле… ради интереса я сверстал небольшую статью: три абзаца, а между ними картинки. Сбросил в сохраненные сообщения и проверил на ноутбуке и телефоне. Оказалось, что шрифт статьи на один-два пункта меньше, чем обычный текст. Получается, тот, кто читает с ноута, будет напрягать глаза. Проверил настройки: шрифт выкручен на максимум, отдельной опции для статей нет.
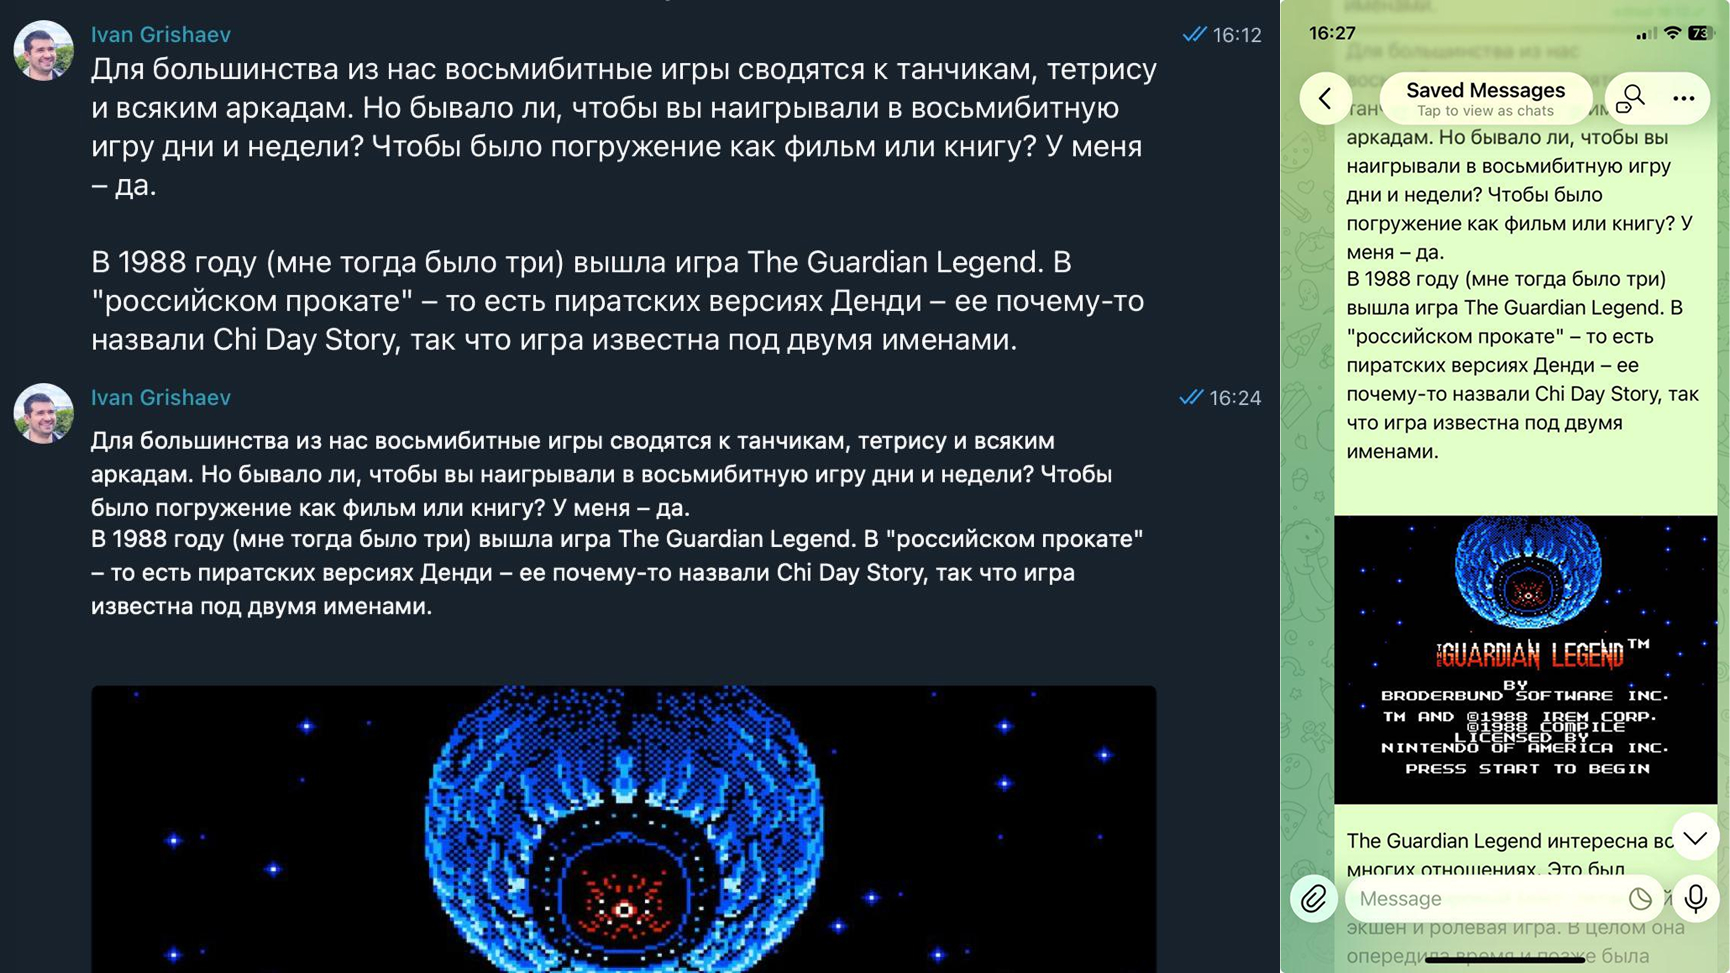
Также в статьях нет отступа между параграфами, приходиться лепить переносы строк.
На телефоне оба шрифта – обычной публикации и статьи – одинаковы, и это хорошо. Но блок статьи срезан слева на один сантиметр. Почему? Зачем его срезать? Для чего пустота слева? Там ни одной кнопки, просто щель шириной в сантиметр, и через нее сквозит фон.
На обоих устройствах клиенты последних версий.
Надеюсь, что в будущем шрифты подтянут. Пока что я не готов оформлять текст с картинками в виде статей: щурить глаза ради чередования картинок – так себе удовольствие.
-
Таблицы в маркдауне
Уж если вы взялись набирать таблицы в маркдауне, то делайте не так:
| id | title | comment |
|---|---|---|
| 1 | some title one | a long comment one |
| 1001 | some | small commant |
| 5551312 | - | foo |
а вот так:
| id      | title          | comment            |
|---------|----------------|--------------------|
| 1       | some title one | a long comment one |
| 1001    | some           | small commant      |
| 5551312 | -              | foo                |
Как я эту кашу буду читать на ревью?
В емаксе это делается ОДНОЙ клавишей — TAB. Для других редакторов есть плагины. Вы и так все сгенерили нейронкой, неужели нельзя хоть чуть-чуть причесать?
-
О присваивании (2)
Небольшая добавка к заметке про
x += 5.В жизни каждого программиста был момент, когда учитель информатики писал на доске:
x = x + 1,после чего смотрел на класс – поймут или нет? Класс, разумеется, не понимал и смотрел на учителя: что он несет? В школьной математике переменные неизменяемы: если взялся решать квадратное уравнение или систему уравнений, x не может по ходу дела переобуться во что-то другое. Да, можно подать на вход разные иксы и получить разные игреки. Но одно дело входные данные, а другое – их мутация в полете.
Учитель начинал рассказывать про коробочку, из которой достали сто рублей, прибавили рубль и положили обратно в коробочку. Что ж, какое-то объяснение это давало. Чувствуя наше сомнение, учитель откровенно продавливал свою аргументацию: если написать в Паскале
x := x + 1, то икс увеличится. Видите?Спорить с этим было нельзя, но ясности не добавляло. Класс принимал объяснение как данность, но знаете что? Где-то глубоко во мне сидела мысль, что учитель сам не понимает, как это работает. Да, он знает, какой получится результат, но не понимает истинных причин. Просто потому, что когда что-то знаешь, объяснение простое.
Если бы меня попросили объяснить, как работает
x = x + 5, я бы ответил так.В языках высокого уровня мы работаем с переменными:
x,yи так далее. Этот код становится машинными командами, а в них никаких переменных нет. Лучше всего это видно на примере ассемблера. В ассемблере нет переменных – только адреса. Для удобства некоторым адресам можно сопоставить метку – логическое имя. Меткой может быть что угодно: переменная, точка входа в процедуру, место, куда нужно совершить условный переход и так далее.Выше я написал “переменная”, но это не совсем верно: в ассемблере нет переменных. Мы резервируем память и одновременно добавляем к ней метку. Если метку убрать, программа скомпилируется и будет работать, просто мы не сможем сослаться на эту память – или сможем, но косвенно, отталкиваясь от других меток.
Таким образом, метка – это адрес, просто именованный. Метка представляет собой число, и к нему можно что-то прибавить, чтобы сместиться в памяти. Если же взять метку в квадратные скобки, получим значение по указанному адресу. В этом и состоит двойственная природа метки: это адрес (число), однако можно либо взять ее значение по адресу, либо поместить значение по этому адресу.
Если предположить, что в ассемблерном коде есть метки
a,bиc, то выражениеa = b + cвыглядит так (пишу по памяти):mov eax [b] ; поместить в eax ЗНАЧЕНИЕ b add eax [c] ; добавить к eax ЗНАЧЕНИЕ c move a eax ; поместить ПО АДРЕСУ a значение eaxВидим, что в случае с “переменными”
bиcмы использовали оператор[], чтобы получить значение. А когда мы “присваиваем” результат вa, квадратные скобки не требуются – метка используется как адрес.Вот почему выражение
a = b + cследует читать так: в адресaзаносится выражение, полученное как… Важно, что не “aстановится” чем-то, а именно “в адресa” заносится то-то и то-то. Большая разница.Язык Си предлагает указатели – читай, именованные адреса с той же семантикой. Мы вправе работать с ними как вздумается: использовать как числа для адресной арифметики или получать из них значения. Указатели – непростая тема, но по крайней мере здесь есть какой-то контроль. В выражении
x = x + 5этого контроля нет. Как я уже говорил, слева от присваивания стоит адрес, а если это что-то сложное вродеitems[get_index(foo)], оно вычисляется, чтобы получить этот адрес.Таким образом, переменная в Си — это тоже метка, и компилятор трактует ее по ситуации: иногда как значение, а иногда как адрес. Единственный язык, где адрес и значение не перемешиваются — это ассемблер. В нем
foo— это всегда адрес, а[foo]— значение по адресу.Как ни странно, присваивание неплохо ложится на объектную модель. Как мы выяснили, переменная – это пара адрес-значение. Ее операции: дай адрес, дай значение по адресу, помести значение по адресу. Можно представить переменную объектом с методами
getиset. В этом случае выражениеa = b + cмы бы записали так:a.set(b.get() + c.get())Или, если речь идет об
x = x + 1:x.set(x.get() + 1)Другое дело, что на тот момент, когда на доске впервые записано
x = x + 1, ученик еще не знает об объектах. Поэтому в ход идет коробочка, из которой достали сто рублей, добавили и положили обратно.Повторюсь: кому-то сказанное покажется банальным, но я считаю, о присваивании говорят мало – а тема очень интересная и сложная.
Writing on programming, education, books and negotiations.